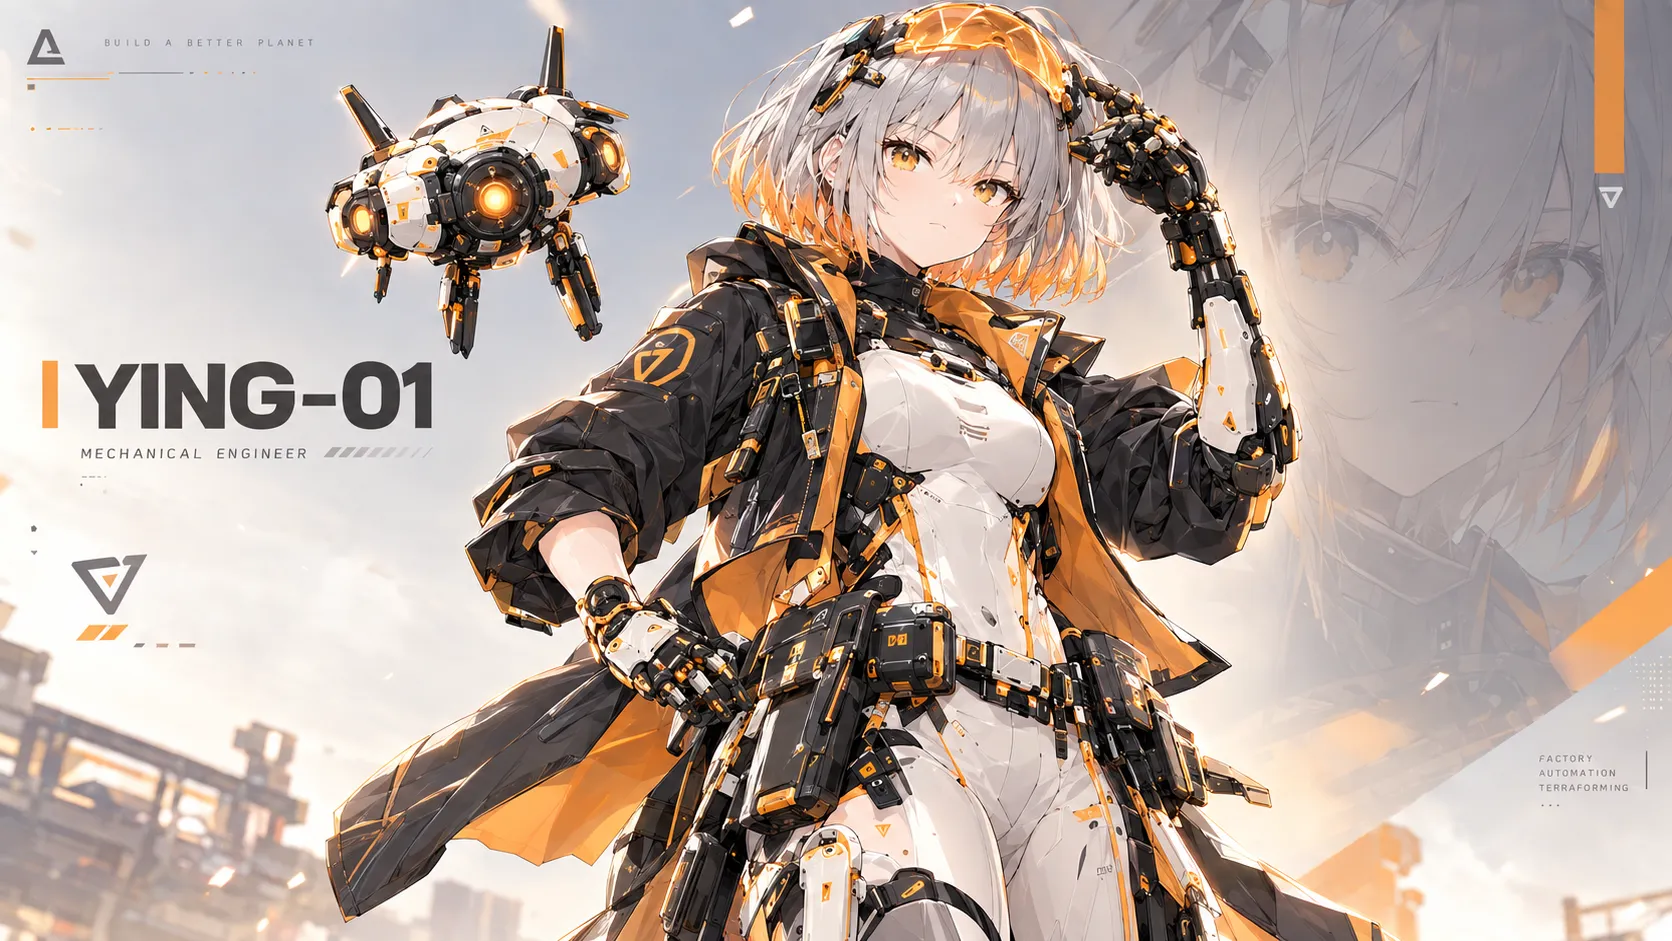
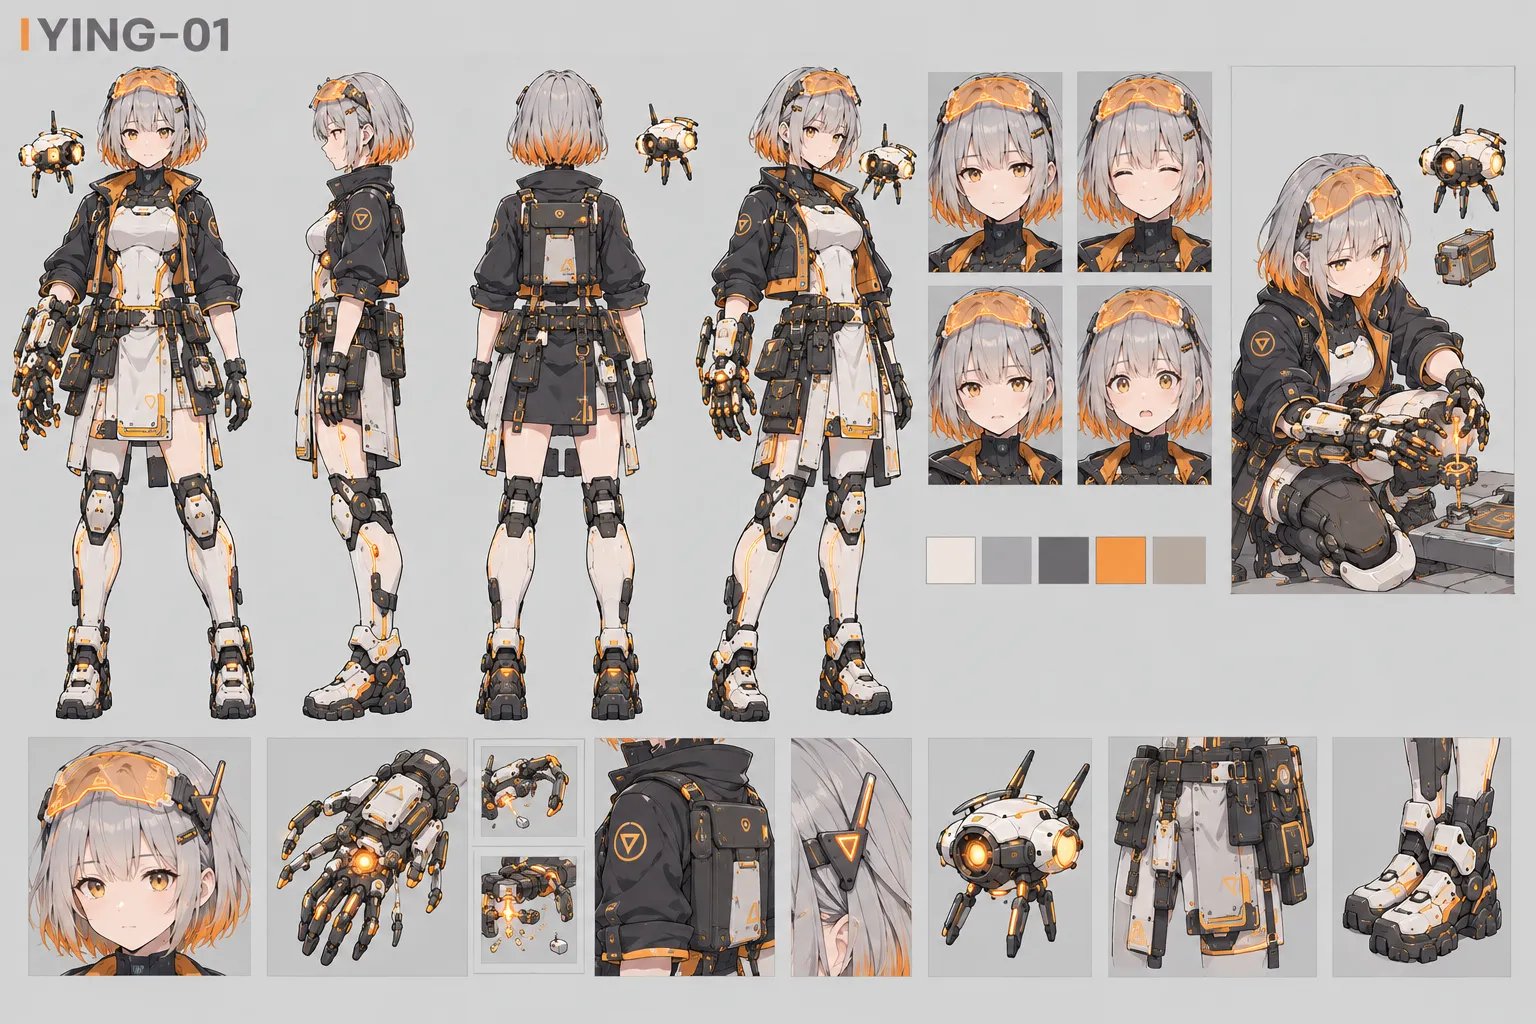
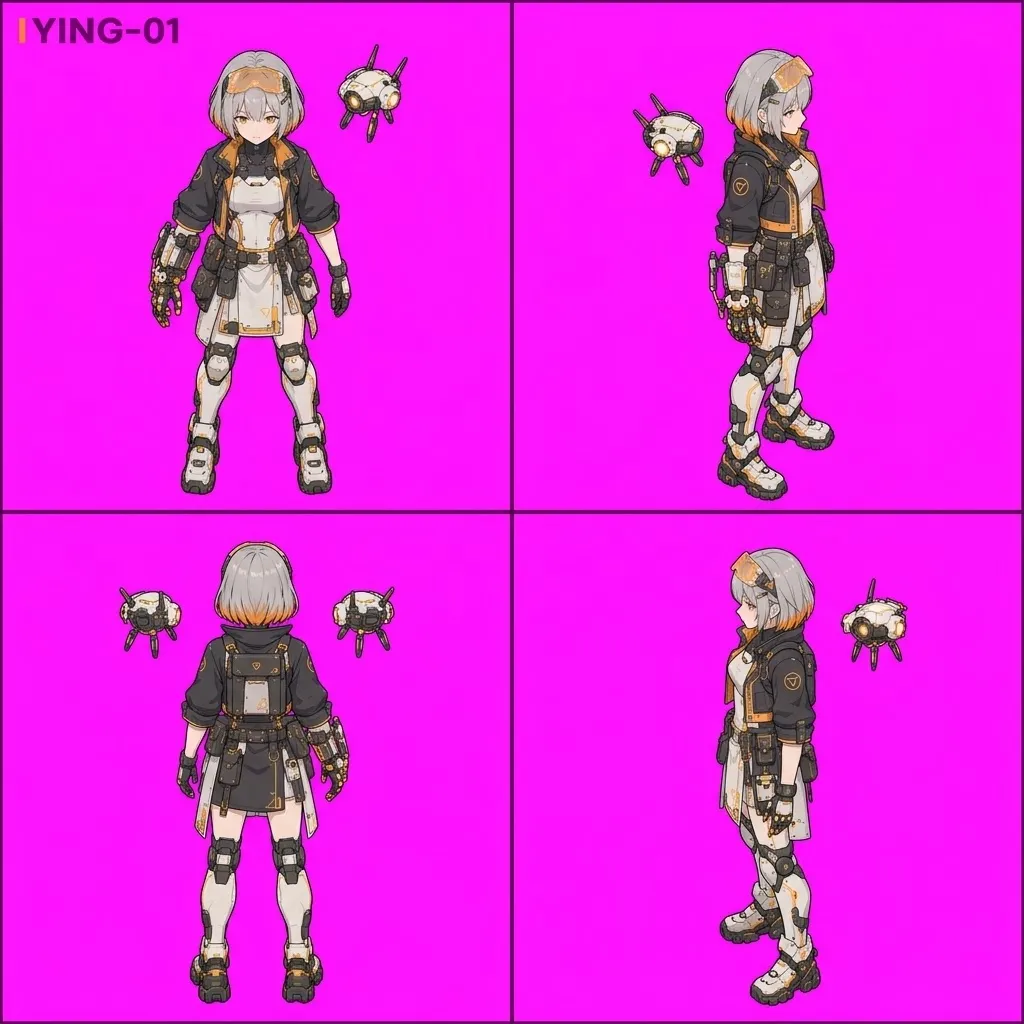
之前在三位角色的设计里,已经生成了萤的设定图:
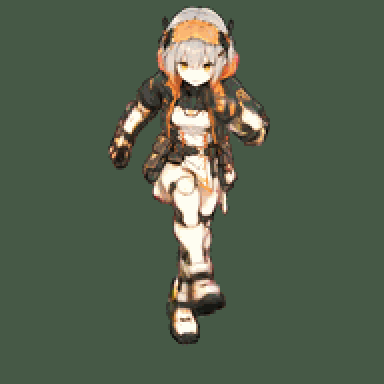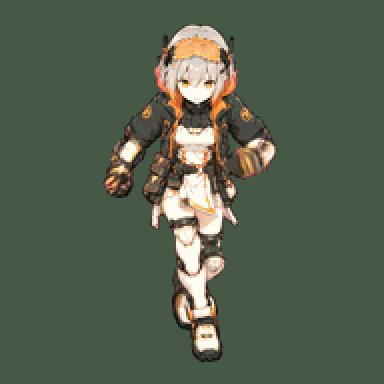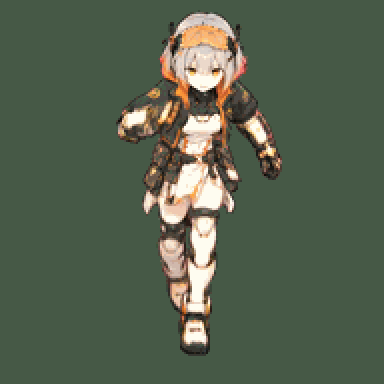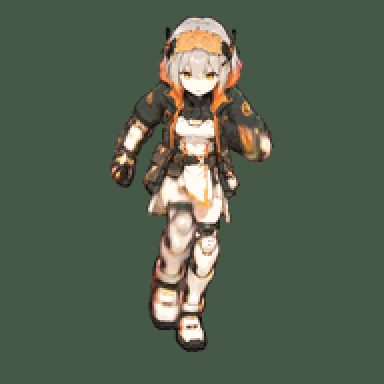
这一篇记录的是萤在地图上的俯视小图资产。最终结果如下(从左到右:南、东、北、西,走路 → 停下 → 待机):
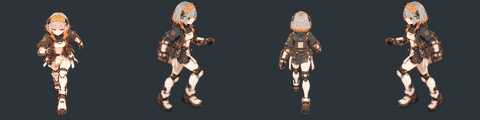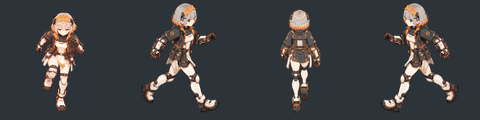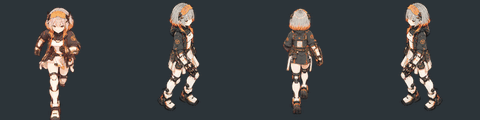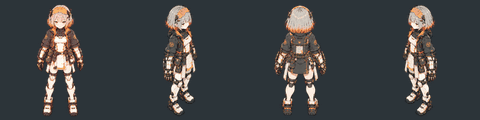
虽然不是很满意 (´;ω;`),但对于一个游戏里只有一百来像素高的资产来说,我觉得可以先用着,毕竟它已经比过程中的版本好得多了。
下面是我的失败集锦 ( ´•︿•̥ )
失败集锦
1. 平视的锚点
第一步是先定一张四方向的”锚点图”,后面所有帧都照着它画。最早出的是平视的版本,单看没问题,但游戏里的建筑都是约 35° 的俯角,人物放进去像贴纸,和场景不在一个视角里。
2. Gemini Flash:一张长条出整段走路
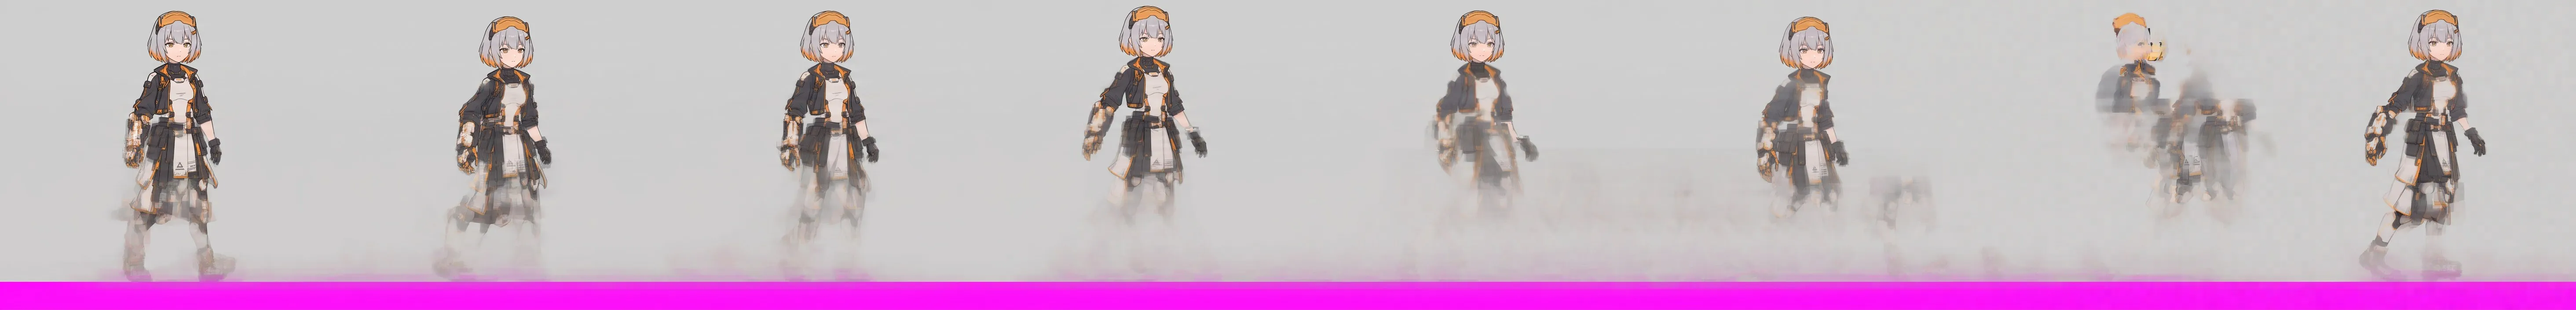
想法很直接:让模型一次画一条 8:1 的长图,8 格就是 8 帧。结果人物越往下越糊,腿基本化掉了,背景色也每格不一样,没法抠图。
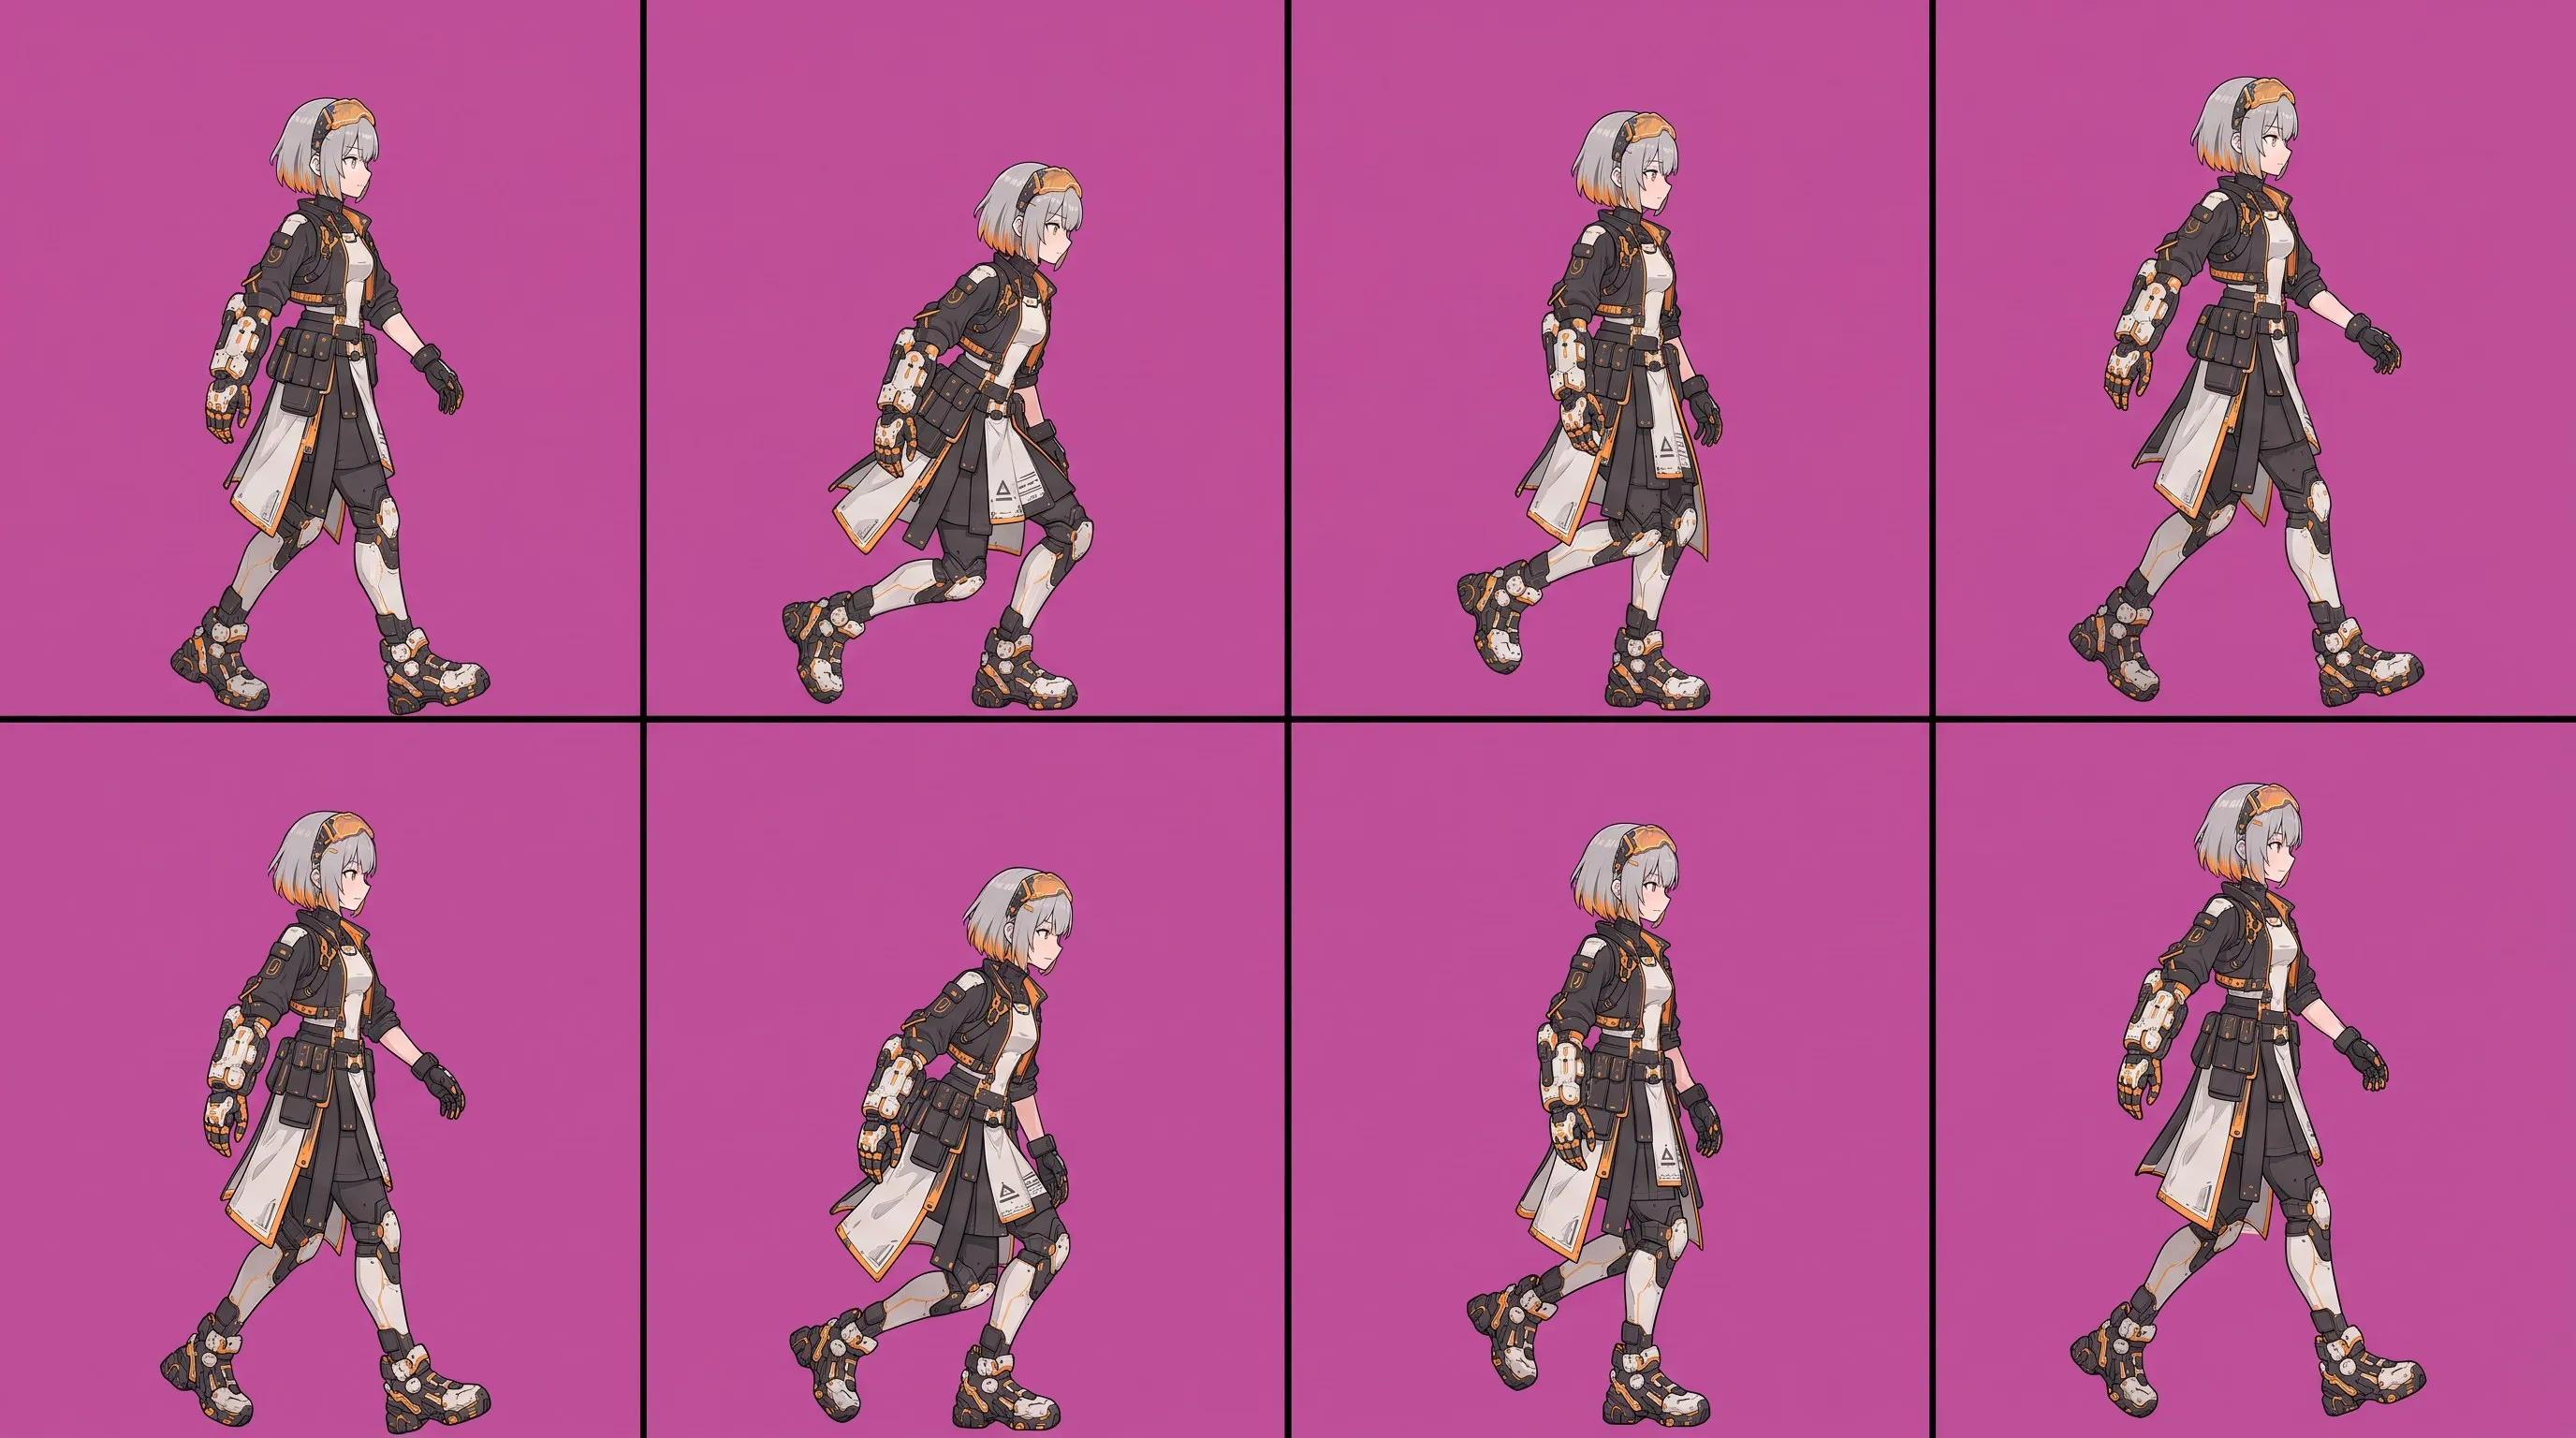
3. Gemini Pro:网格
换成更强的 Pro 画 2×4 网格。这次画得其实挺好看,但我要的是正面,它给了侧面;每格之间的步伐也不连贯,背景也不是能直接抠掉的纯色。
4. ChatGPT:一张图出所有帧
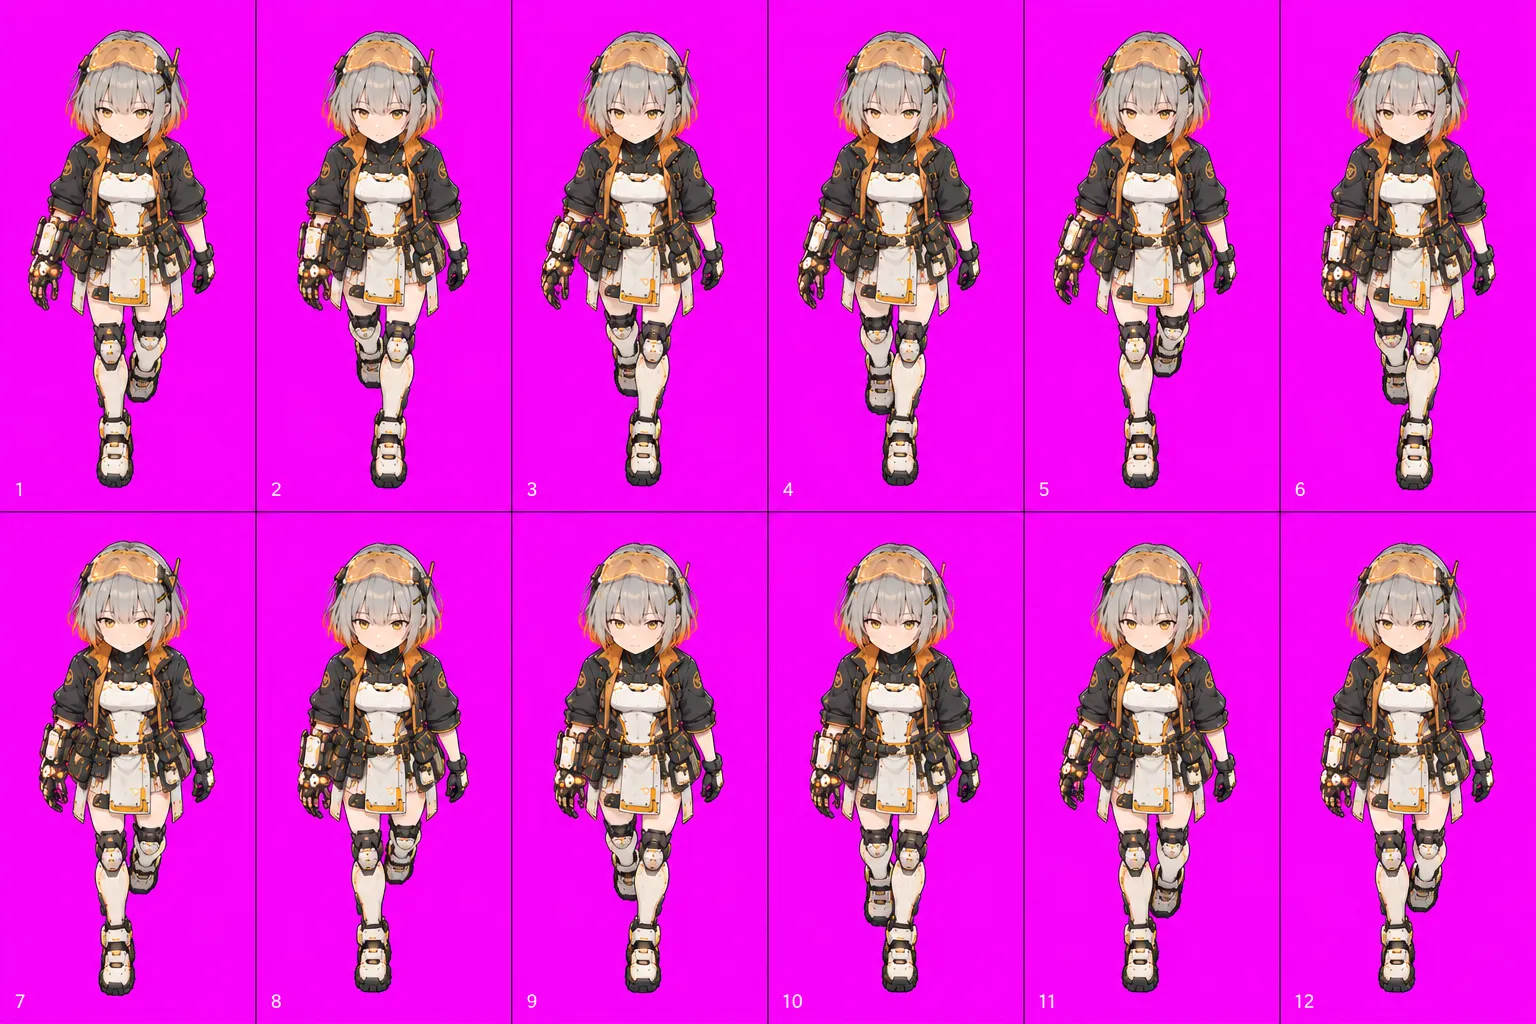
ChatGPT 画单个姿势非常稳,所以我试着让它一张图出 12 格正面走路。问题是它不理解”连续”:相邻两格经常换了一只脚在前,也没有两腿交错的中间姿势,播出来是在原地抽搐。
5. Veo:只靠文字描述动作
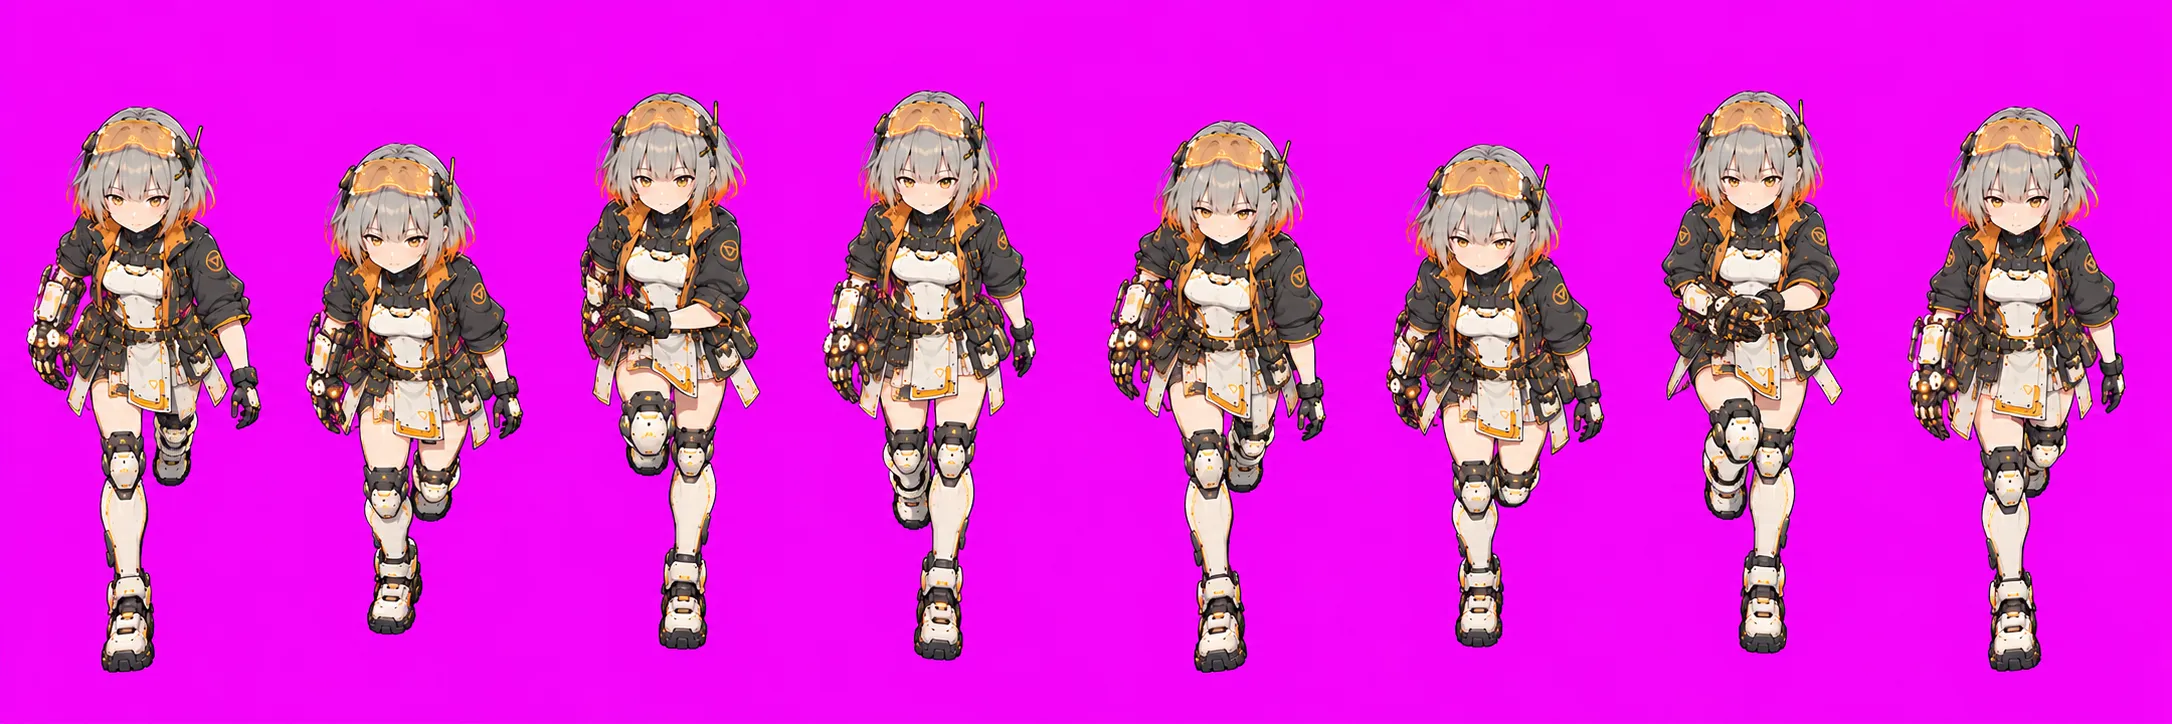
既然图像模型不懂连续,那就直接用视频模型 Veo 生成走路视频,再从里面抽帧。动作是连续了,但只给锚点加一段动作描述的话,它走得很”淑女”,缺乏动感;提示词写得越长,它越会抓住其中某个词过度发挥,越改越怪。
最后跑通的做法
试到这里结论就清楚了:让每个模型只做它擅长的那一件事。
- ChatGPT(网页版)只画静态姿势:锚点站姿,加上大步落地的关键帧。
- Veo 只负责两个姿势之间的动作:用”首尾帧”模式,给它第一帧和最后一帧,它补中间的 4 秒。
- 剩下的交给脚本:抠图、统一大小、挑帧、拼精灵表。
先把动作拆开
动手生成之前,先想清楚游戏里到底需要哪几段动作、它们怎么衔接。我把萤在地图上的动作拆成三段:
| 动作 | 播放方式 | 由什么生成 |
|---|---|---|
| 走路 | 循环 | 关键帧 A → B → A |
| 停下 | 只播一次 | 关键帧 → 站姿 |
| 待机 | 循环 | 站姿 → 站姿(呼吸) |
切换规则也很简单:
按下方向键 → 立刻开始走路(不加起步过渡,手感优先)松开方向键 → 播一遍"停下",播完进入待机停下途中又按键 → 直接打断,回到走路起步不做过渡是故意的:玩家一按键人就该动,哪怕多等几帧都会觉得”粘手”。停下则不同,多几帧收势反而显得自然。
还有一个小技巧:走路时松手,有一半的概率是”另一只脚在前”。正面和背面左右对称,这时把停下动画整段镜像播放就能接上,不用多生成一条;侧面镜像会连朝向一起翻过去,所以侧面不做这个处理。
这样拆完,每个方向只需要 2~4 条短视频,所有素材都围绕”关键帧”和”站姿”这两张图展开。
1. 锚点和关键帧
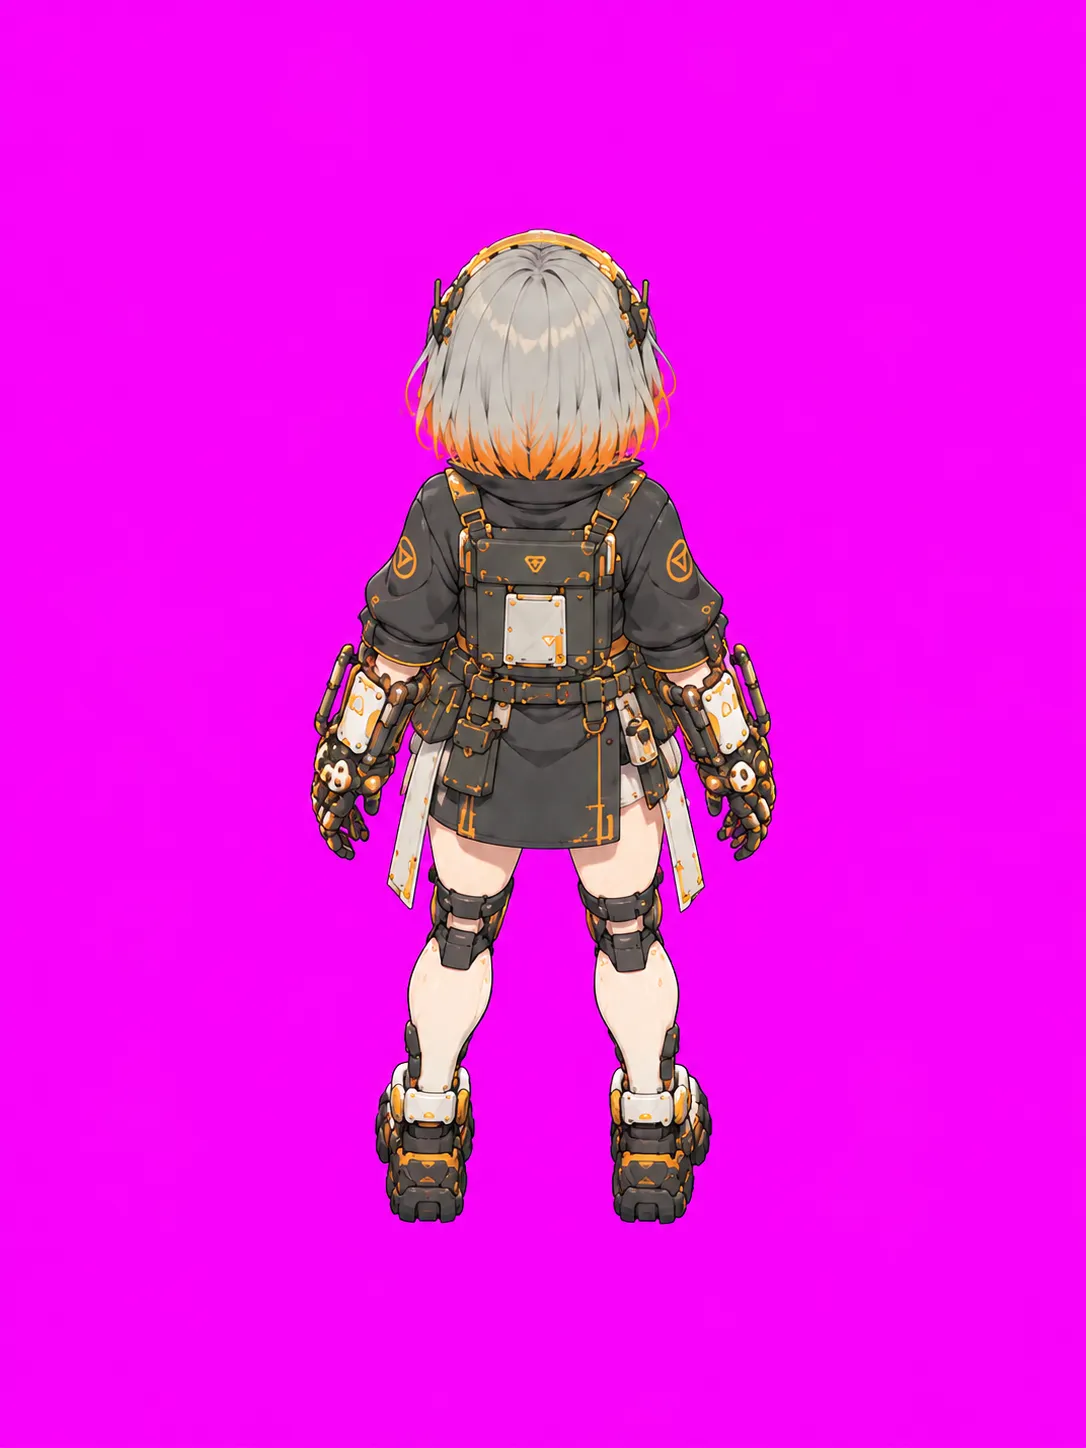
先让 ChatGPT 出一张四方向、35° 俯角的站姿锚点,视角从这里定下来:
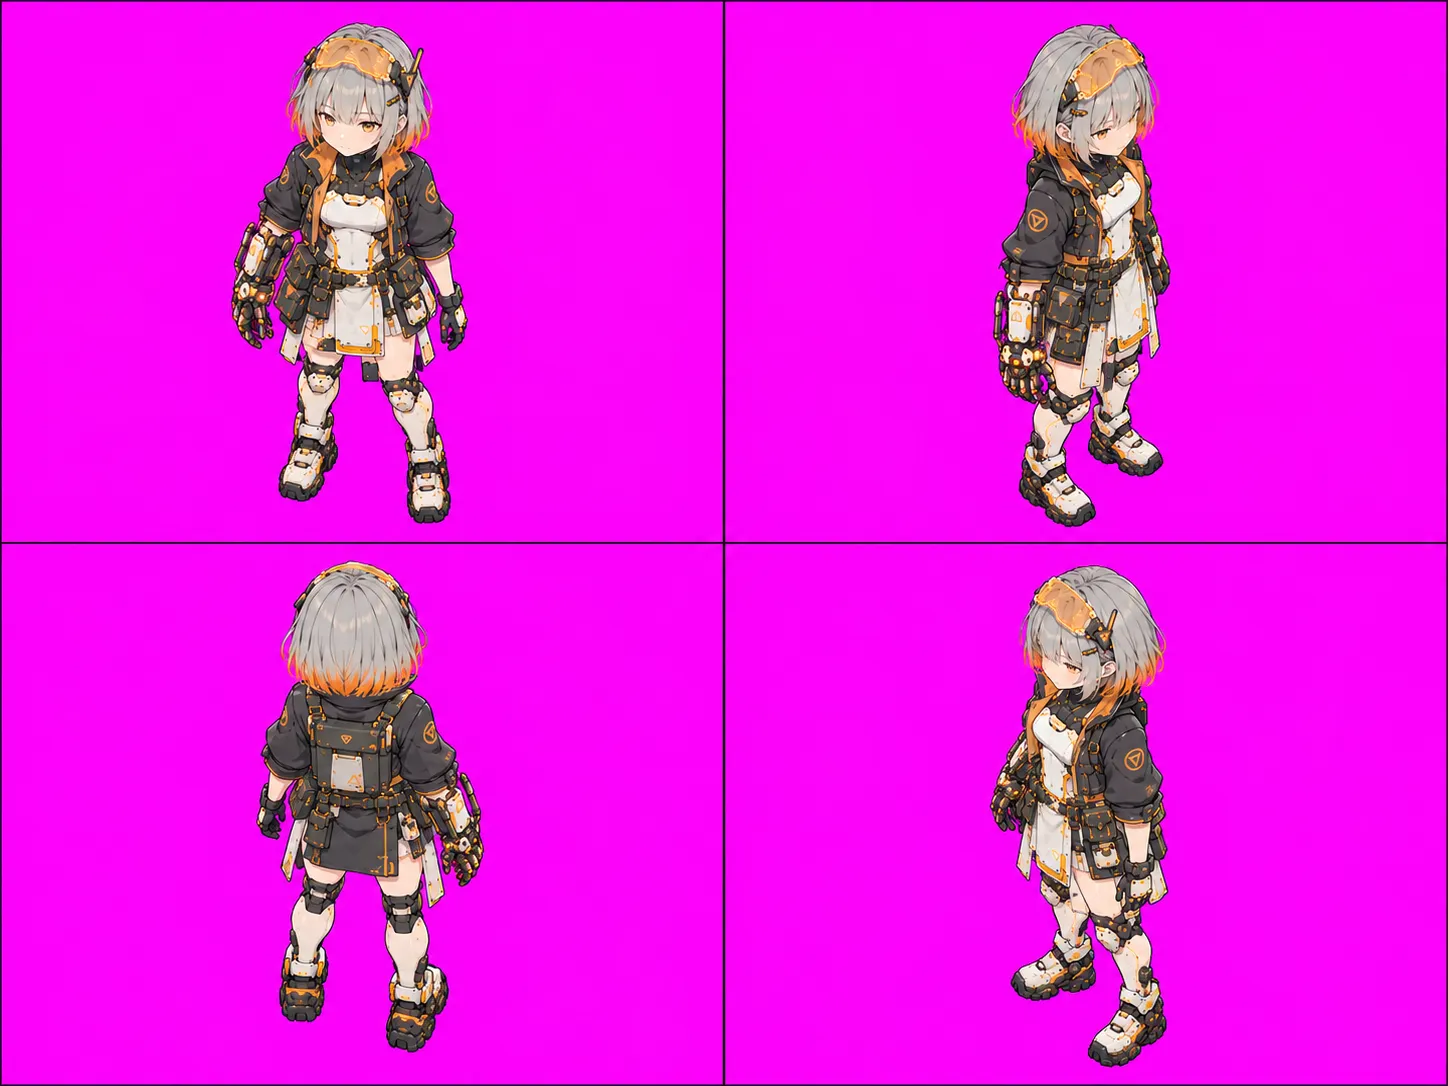
然后每个方向出关键帧:大步落地的瞬间,一只脚在前。正面和背面左右对称,另一只脚在前的那一张直接水平镜像就行,不用再画。
2. Veo 首尾帧补动作
每个方向生成几条 4 秒的视频:
- 走路:关键帧 A → 镜像 B、B → A,两条接起来就是一个完整的走路循环
- 停下:关键帧 → 站姿
- 待机:站姿 → 站姿,只让她轻轻呼吸
提示词压到最短,只写怎么动,比如”大步快走、面向镜头、镜头不动”。之前的教训是:描述越多,它越容易跑偏。
3. 侧面:同一张图做首尾帧
侧面是最麻烦的。我让 ChatGPT 画”另一只脚在前”的侧面,它画出来的两张几乎一模一样,怎么改提示词都没用。
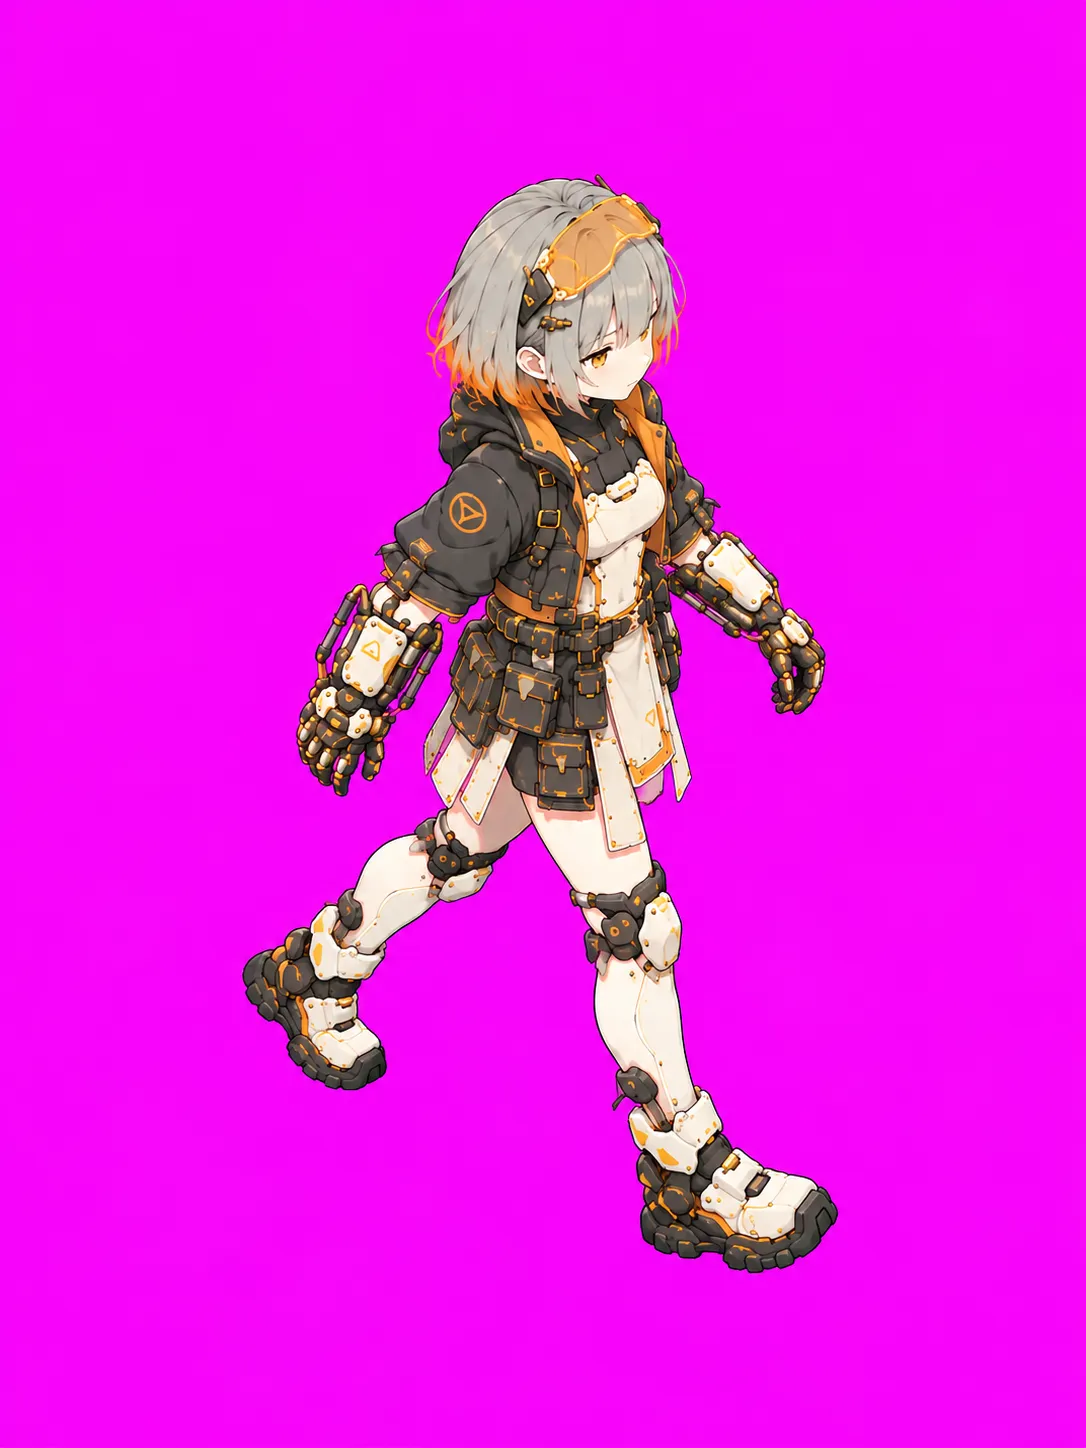
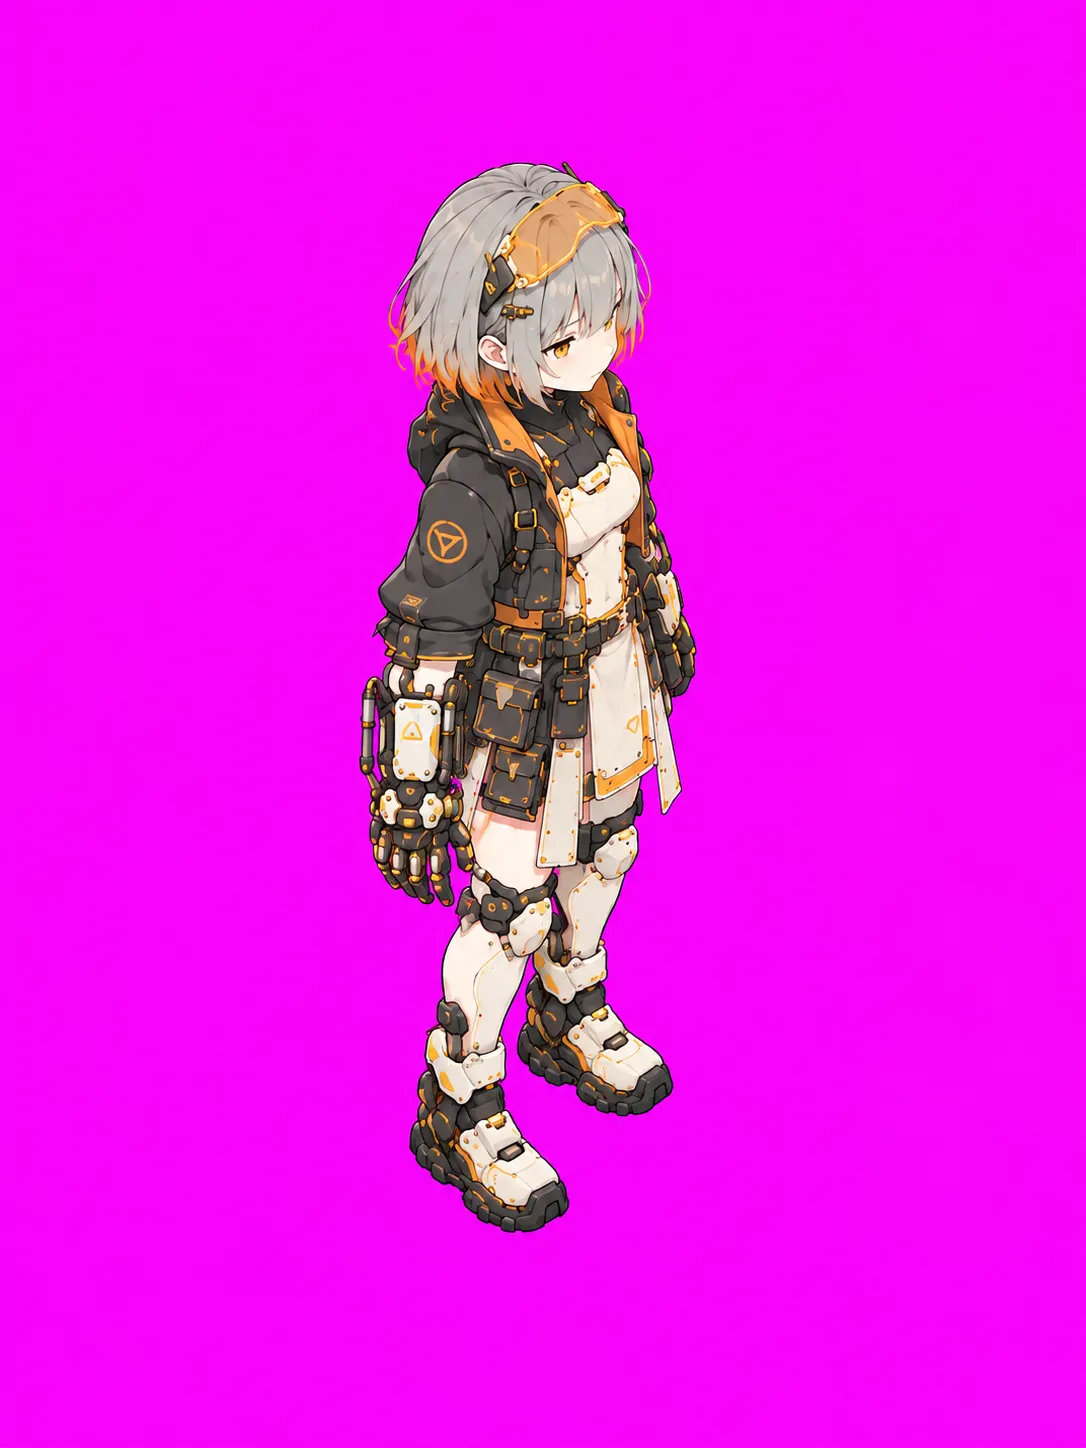
后来干脆不要第二张了:首帧和尾帧都用同一张关键帧,让 Veo 自己走完一整圈再回到原姿势,再从视频中间截一个完整的步态周期。效果反而不错。西向直接用东向镜像。
4. 背面:剪掉跑偏的片段
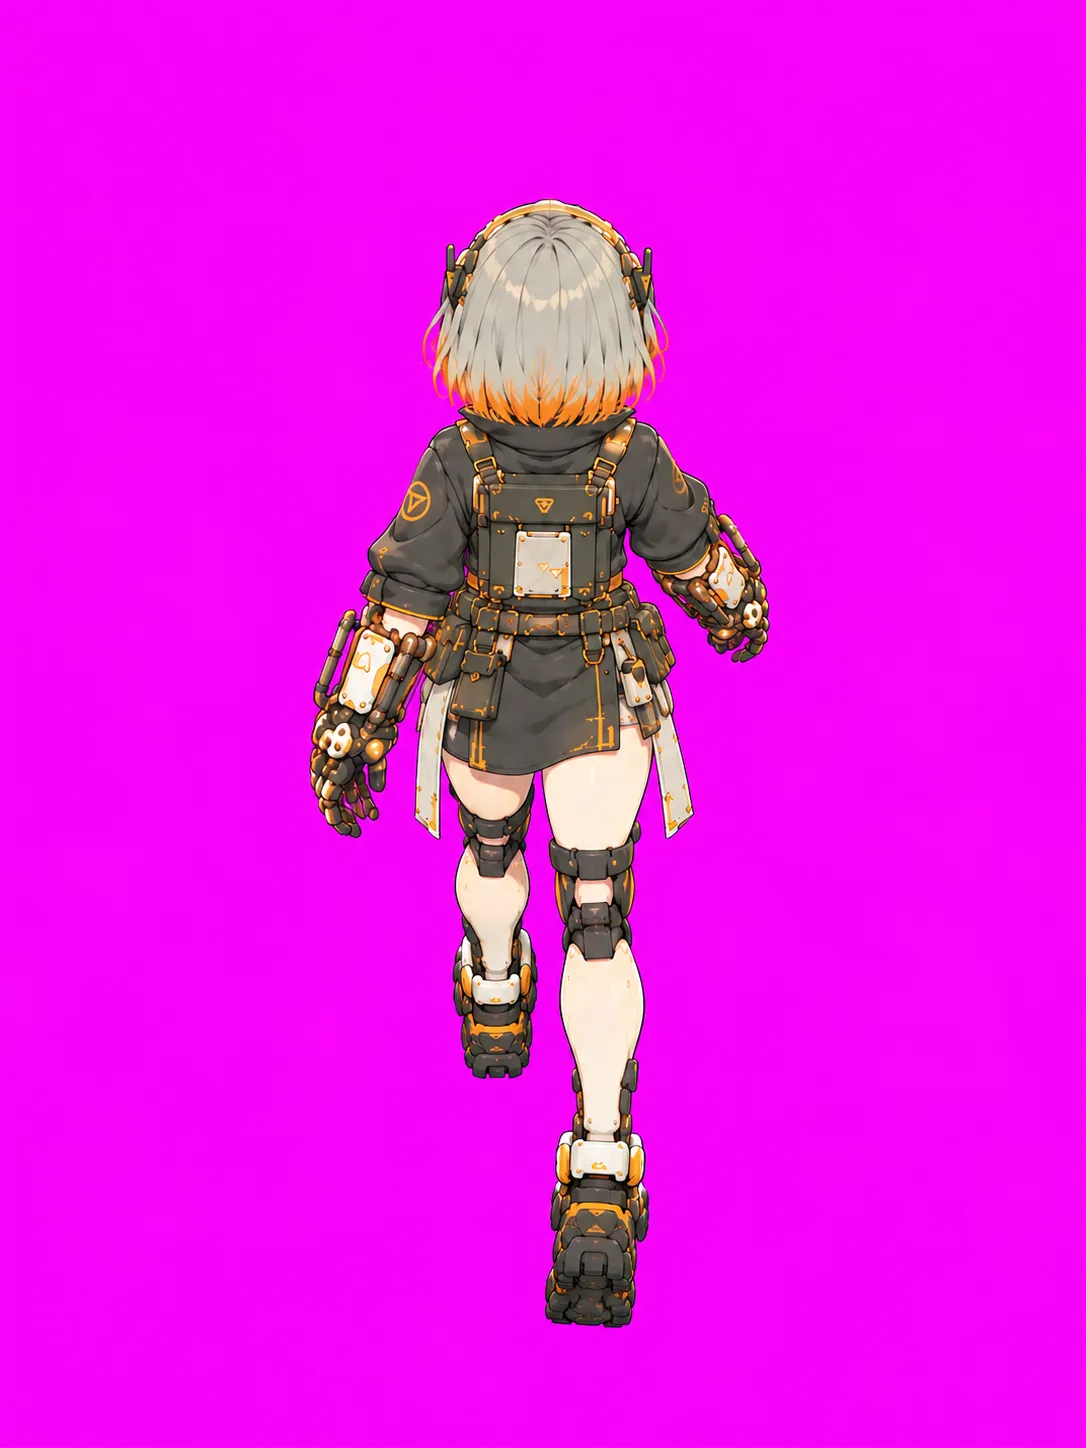
背面照正面的办法做,但有一条视频中间,她的腿突然往左边踢了出去。重新生成一次后好了一半,剩下那段就靠剪辑:在坏掉的片段前后各找一帧最像的,直接接起来,接缝几乎看不出来。
5. 挑帧和大小校正
视频里的速度是不均匀的,有快有慢。如果按时间等间隔抽帧,游戏里播起来会一顿一顿的。所以按”动作量”来抽:
每两帧之间的变化量 → 累加成一条"动作进度"在这条进度上等间隔取 12 个点 → 就是 12 帧另一个坑是:ChatGPT 画的关键帧普遍比站姿大一圈,走路时人会忽大忽小。处理方法是按头的宽度换算比例,把走路帧缩回站姿大小;停下的那段从走路的大小渐变到站姿的大小,这样停住的瞬间不会跳。
最后把四个方向的走、停、待机拼成一张精灵表,游戏按行读取。下面是直接从 Veo 原视频裁出来、没有缩小也没有调色的全部动作,能看清细节:
花费
整个萤的试错过程,包括上面所有失败的版本,API 一共花了 $6.91(ChatGPT 网页版是订阅制,不算在内)。
小结
- 图像模型擅长单个姿势,不擅长连续的帧;视频模型正好相反。分开用,各管一段。
- 提示词越短越好,让参考图去说话。
- 侧面不需要两张关键帧,同一张做首尾就行。
- 抽帧要按动作量,不要按时间。
这套流程之后会用到序和遥身上,还有干活之类的新动作。希望下一次能少踩几个坑 (๑•̀ㅂ•́)و✧